先说一个暴论:
未来两年,VLA 和 WAM 仍然无法带领具身智能走向真正的开放世界泛化。下一个行业热点,不会只是更大的 VLA 或 WAM,而是由 Codex、Claude Code 这类强大通用 Agent 驱动的具身系统。
VLA 和 WAM 当然还会进步,也依然是机器人最重要的基础能力。但它们面对的根本问题没有改变:具身数据太少,生产效率太低,不足以支撑开放世界泛化。
而以 Codex、Claude Code 为代表的通用 Agent,已经拥有强大的泛化能力。这种智能更加便宜、更容易复制,也比单一操作者或单个策略模型能够同时理解更多类型的信息。
如果这条判断成立,具身智能的研究中心就会发生变化:从训练一个更大的模型,走向建设一个能够持续获得智能的系统。
这个系列一共分为七篇:
- 为什么具身 Agent 会成为下一个热点。
- 具身 Agent 到底是什么。
- 具身 Agent 系统为什么能扩大模型能力。
- VLA 和 WAM 应该如何适应 Agent 系统。
- 为什么未来的系统会越来越简单而强大。
- 具身 Agent 时代将如何影响行业和企业。
- 个人如何跟上具身 Agent 时代?
这篇是整个系列的第一篇。我们先从最根本的问题开始:为什么最近如此热门的 VLA 和 WAM,短期内仍然不够?
一、VLA 和 WAM 为什么还不能真正泛化?
核心矛盾是:需要泛化的开放世界呈指数级复杂,具身数据却仍然只能线性增长。
我个人评估过各种 VLA 和 WAM。它们在论文中宣传的效果都很好,但距离真实环境下的泛化,仍然相差很多个数量级。
因为开放世界中的变化不是相加,而是相乘的。
物体、位置、环境、任务和机器人本体相互组合,会形成一个巨大的任务空间。但具身数据的生产仍然是加法:多一个人、多一台设备、多一段采集时间,才能多得到一批数据。
目前公开的头部数据中,具身操作第一视角数据约为 2,000 小时,HiFi-UMI 声称采集超过 20,000 小时,真实机器人数据也达到了约 20,000 小时。【1】
这些数字看起来很大,但与开放世界中的组合数量相比,仍然非常有限。
所以,VLA 和 WAM 面对的是一个难以回避的矛盾:
需要泛化的空间在做乘法,可以用于训练的数据却还在做加法。
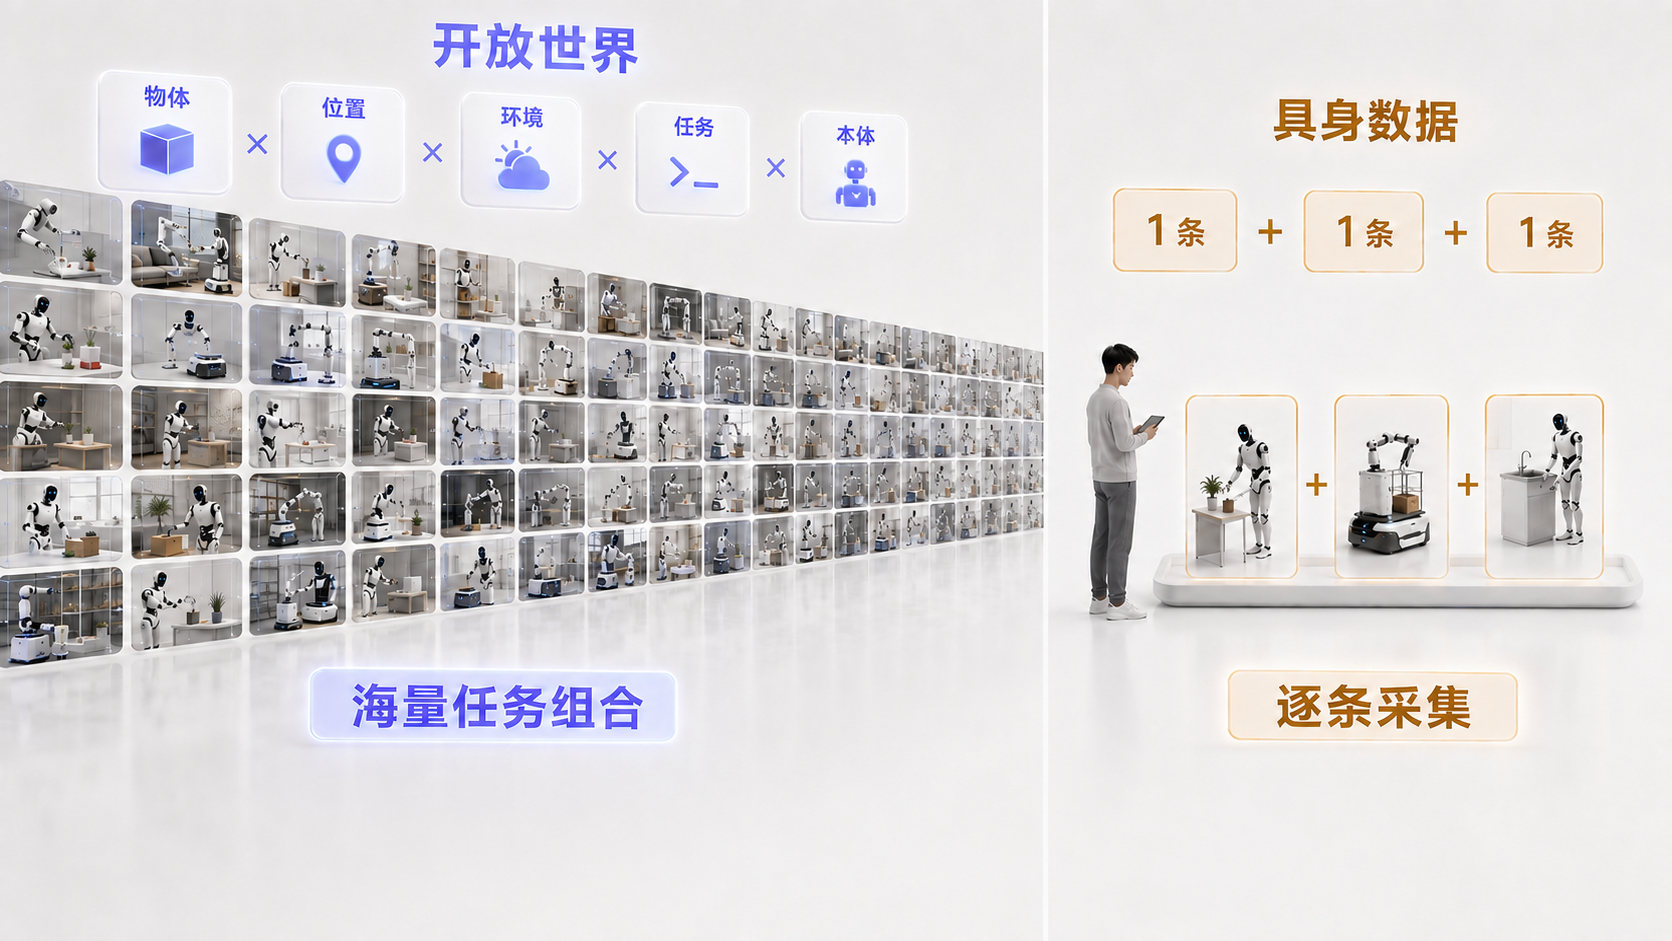
未来两年,具身数据会继续增加,VLA 和 WAM 也会继续变强。但如果数据的增长方式没有改变,它们与开放世界泛化之间的数量级差距就很难被迅速填平。
二、具身数据是一条低效的智能转移通道
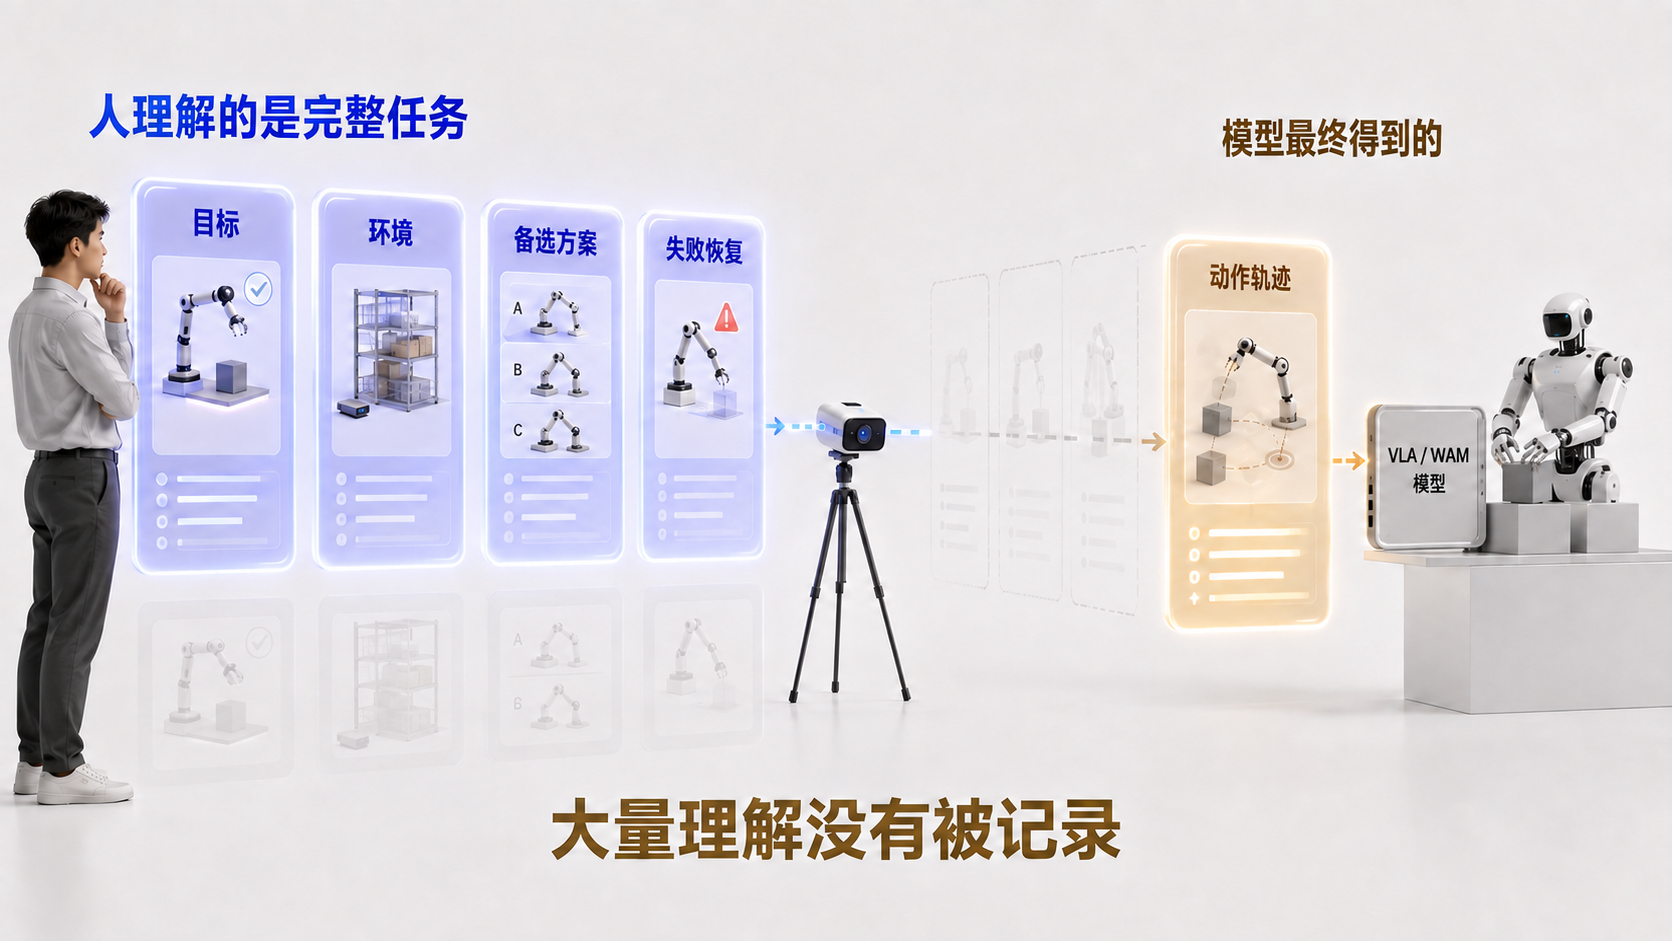
VLA 和 WAM 这些模型需要依赖具身数据获得智能。在传统具身训练中,人需要理解任务、观察环境、选择动作,再把这些判断变成机器人数据;模型通过训练,将数据中的智能转移到自己的参数中。
但具身数据通常只记录人最终做了什么,无法完整记录人为什么这样做,以及环境变化以后应该怎样调整。不全面的具身数据导致智能转移效率低,模型能够获得的泛化能力也因此受到限制。
三、通用智能体如何补上泛化缺口?
以 Codex、Claude Code 为代表的通用智能体,已经具备较强的理解和组合能力,可以把基座模型中已有的通用知识反复用于不同任务。
如果机器人必须见过每一种物体、环境和任务组合以后才能完成任务,那么数据永远追不上开放世界的变化。
但如果通用智能体能够理解当前问题,并将已有能力重新组合起来,机器人就不需要为每一种新组合都单独采集数据。
两者的关系可以概括为:
VLA 和 WAM 提供真实的物理操作能力;
通用智能体补充更加广泛的理解与组合能力。
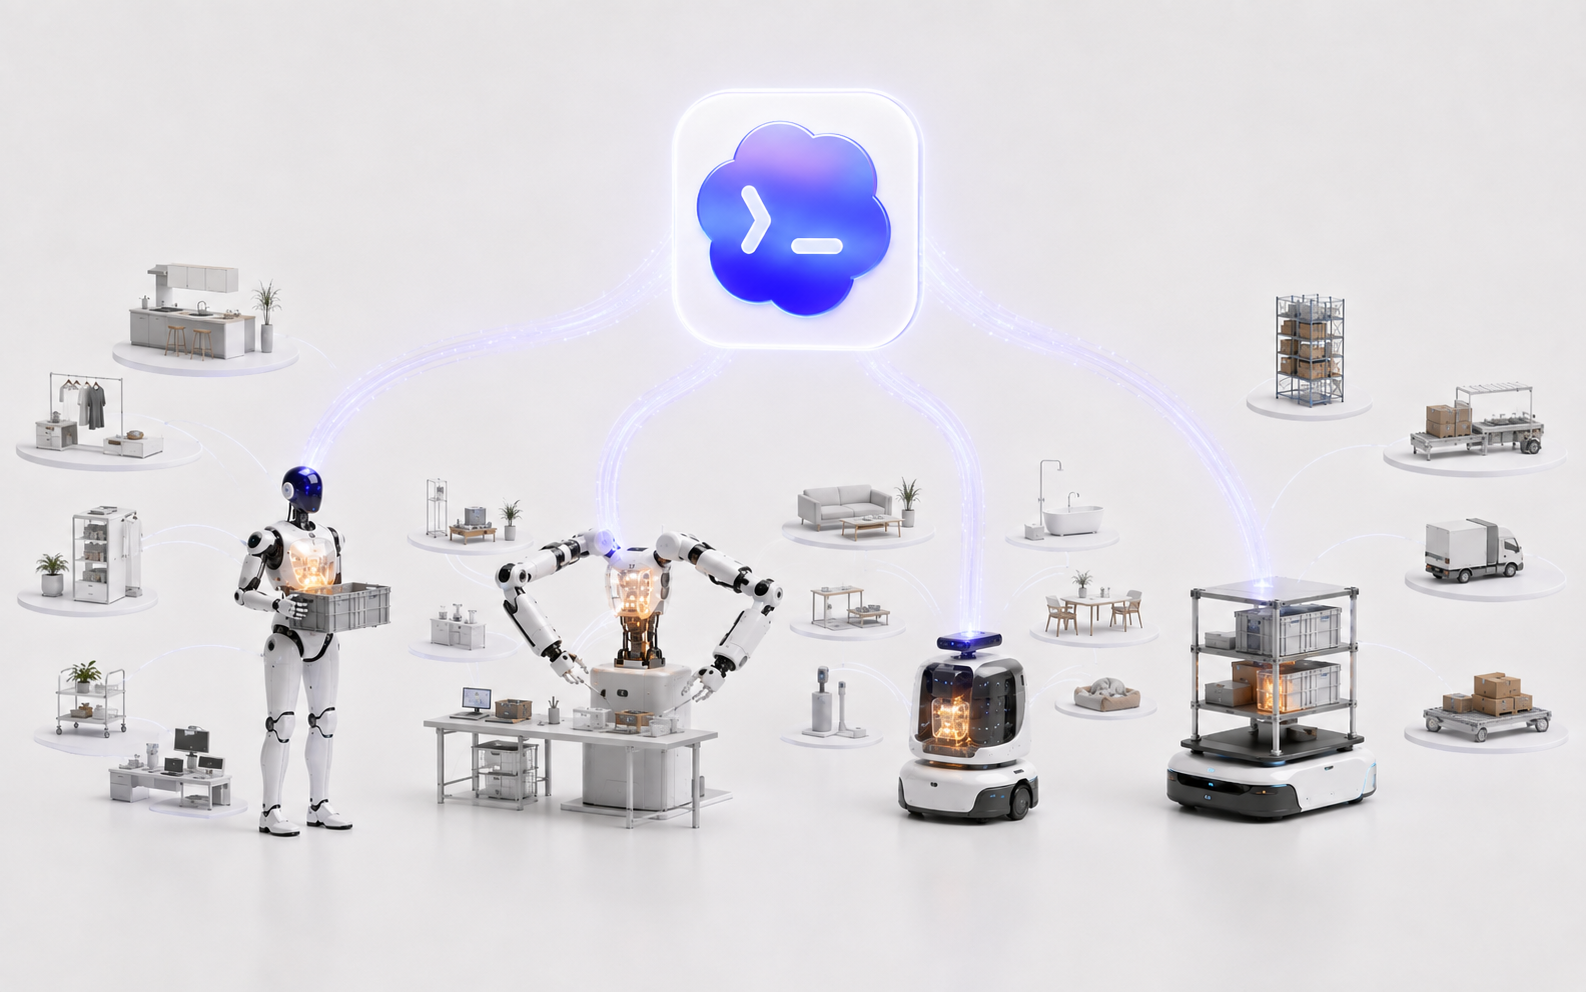
这种补充可以同时发生在训练和部署中。
在训练阶段,通用智能体可以让同样的人工和设备投入覆盖更多任务变化,提高数据中包含的智能密度。
在部署阶段,它可以综合当前任务、环境、机器人状态、历史信息和模型表现,直接处理训练数据没有逐一覆盖的新情况。
相比单一操作者或单个策略模型,系统可以同时综合更多类型的信息。
所以,通用智能体的价值不是替代人类、具身数据或者 VLA 和 WAM,而是把一部分数据覆盖问题转化为理解与组合问题:
过去,每增加一种任务组合,都可能需要重新采集一批数据;未来,系统可以通过通用智能体的泛化能力,用有限的具身数据覆盖更大的任务空间。
这正是具身 Agent 有机会缓解“开放世界做乘法、具身数据做加法”这一矛盾的原因。
VLA 和 WAM 决定机器人已经学会了哪些物理能力,具身 Agent 则让这些能力能够被更灵活地理解、组合和使用。
具身 Agent 不会让数据变得不重要。它真正改变的是:机器人不再需要等待数据覆盖所有情况以后,才能开始面对开放世界。
这就是为什么我认为,具身 Agent 会成为下一个行业热点,并加速机器人进化。
引用与来源
【1】当前具身数据的公开头部规模
Open-AoE、HiFi-UMI、LingBot-VLA。
聊聊这篇文章