上一篇我们谈到,通用 Agent 可以为具身智能补充更广泛的理解与组合能力。
但具身 Agent 到底是什么?它和常见的 Planner+VLA,又有什么区别?
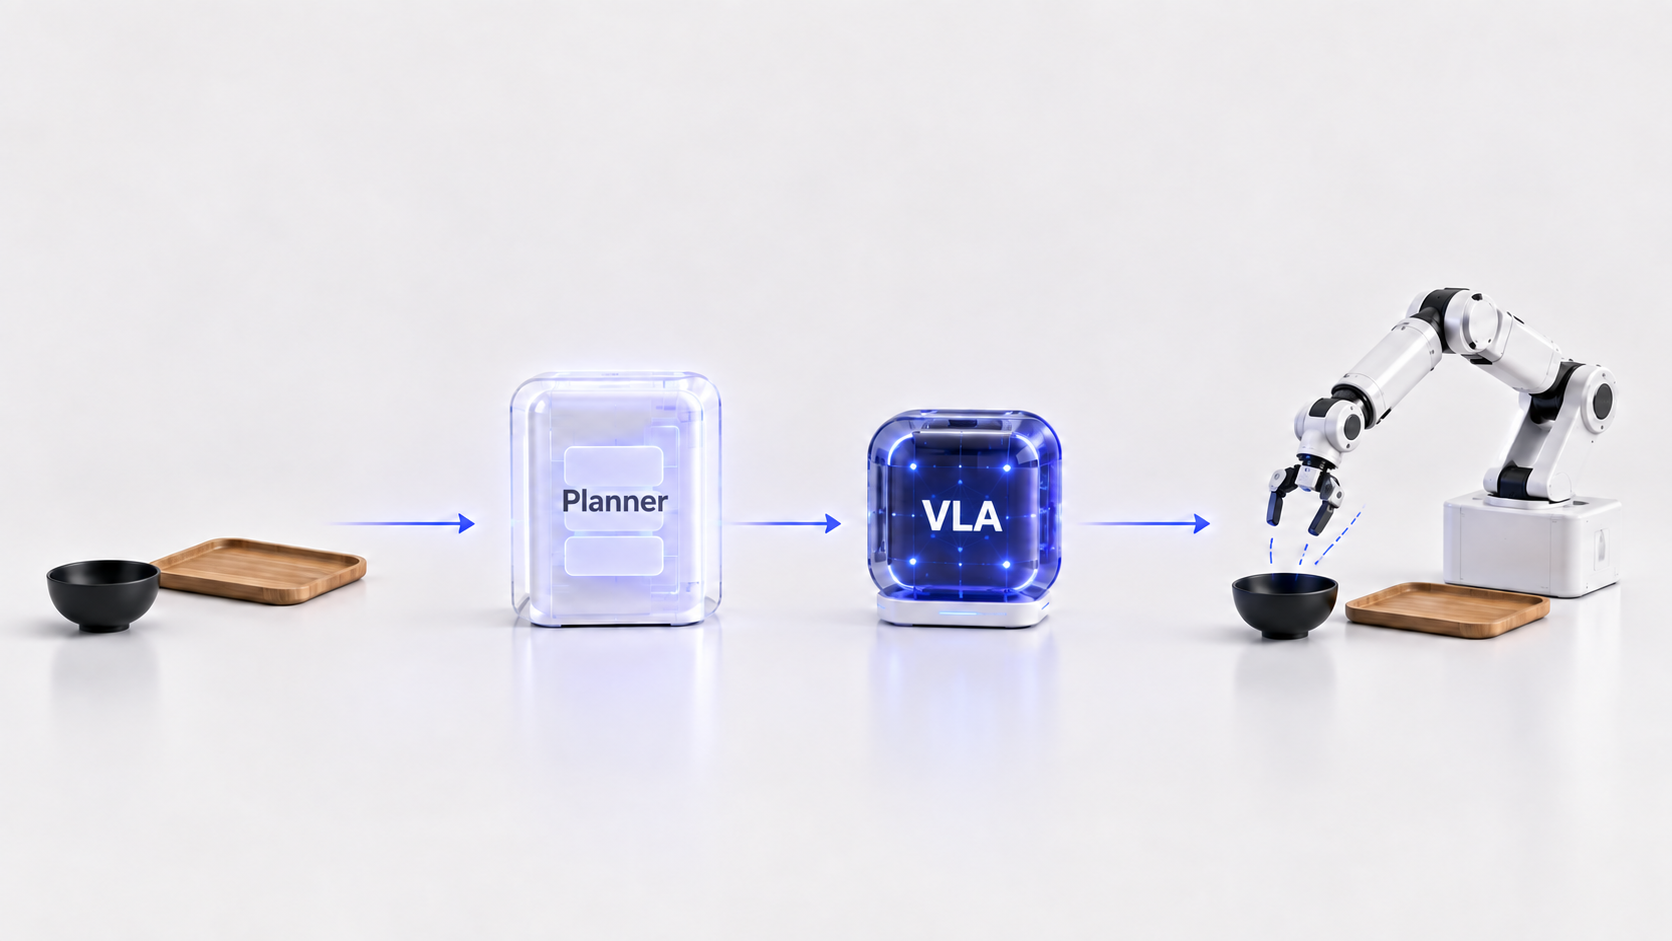
一、Planner+VLA 仍然是一条单向执行链
Planner+VLA 的基本逻辑是:
接收任务 → 分解任务 → 调用 VLA → 输出动作。
它解决的是“复杂任务如何拆成多个动作”,但整套流程仍然默认:计划是正确的,动作也会按照预期执行。
问题在于,物理世界不会完全按照计划运行。
机械臂可能没有抓住物体,物体可能在执行中发生位移,原本可行的路径也可能突然被遮挡。
如果执行以后不能重新观察和调整,那么 Planner 只是让机器人拥有了计划,还没有让它成为 Agent。
二、具身 Agent 是围绕现实目标运行的闭环
具身 Agent 关注的不是“有没有输出动作”,而是“现实目标有没有完成”。
它需要持续围绕目标运行:
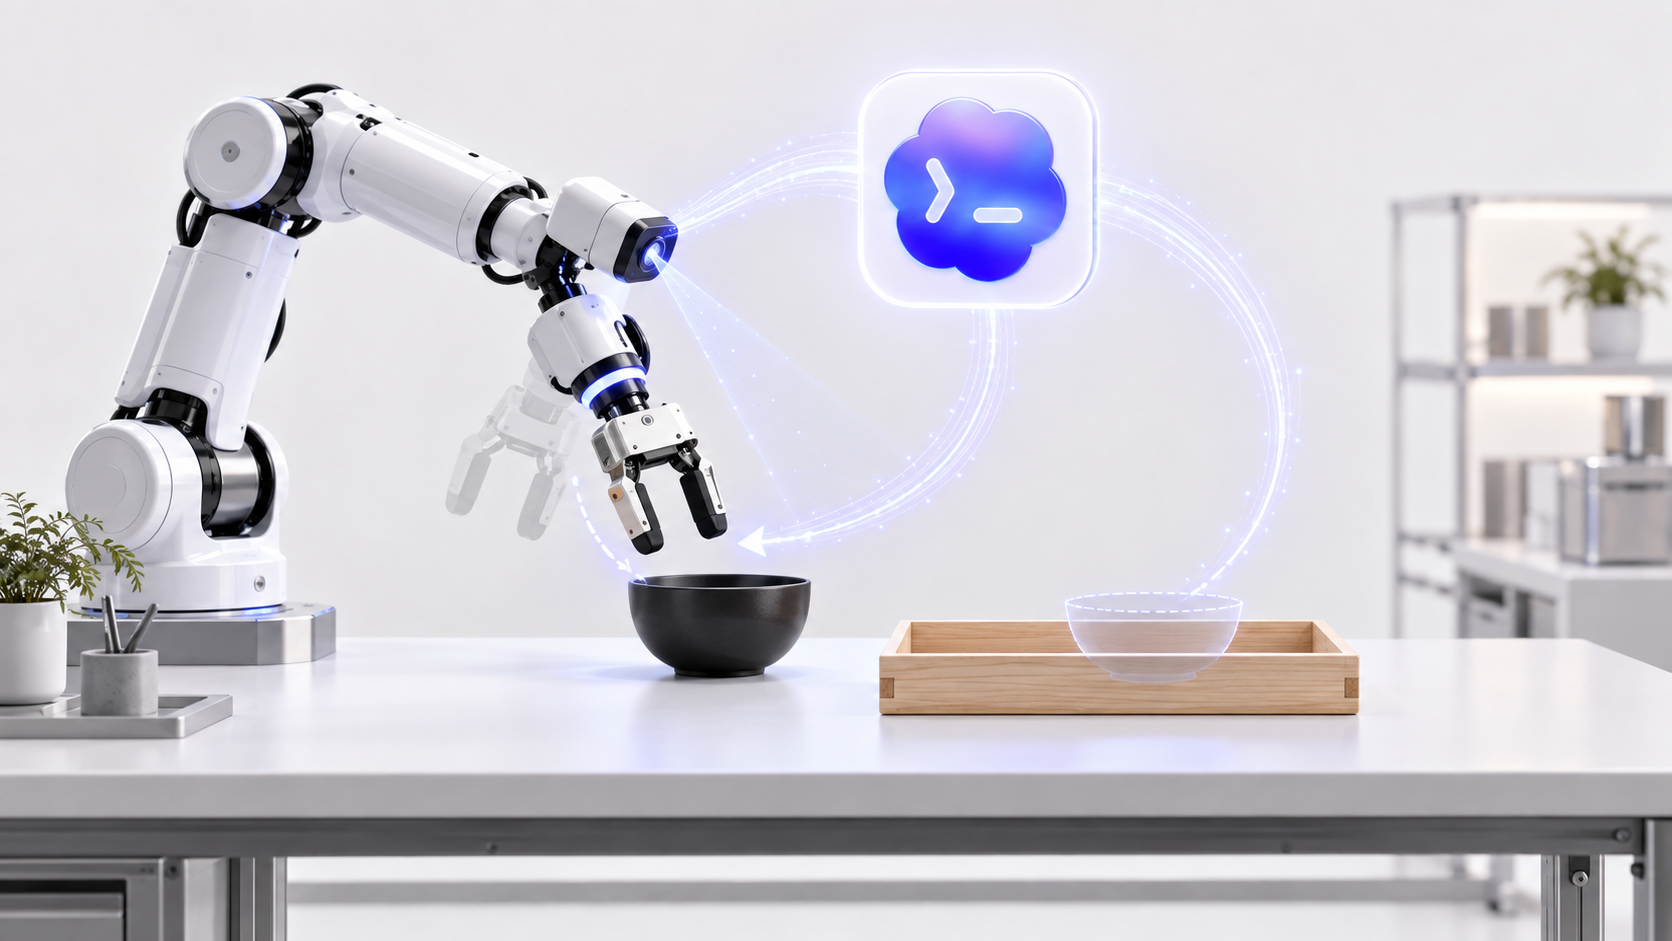
理解状态 → 调用能力 → 执行动作 → 检查结果 → 继续或调整。
因此,我更愿意这样定义:
具身 Agent,是能够围绕现实目标,根据环境和执行结果持续调整行为的智能体。
例如,让机器人把黑色碗放进木托盘。Planner 可以生成“找到碗、抓取、移动、放下”的计划。
但如果机器人没有抓住碗,继续执行后面的动作就没有意义。具身 Agent 会检查抓取结果,再决定继续、重试或者调整方法。
所以:
Planner 解决“准备怎么做”,具身 Agent 解决“如何根据现实反馈,把事情真正做完”。
三、具身智能应该从模型中心走向系统中心
过去,具身智能主要围绕一个问题展开:
能不能训练出一个模型,直接从观察和指令生成正确动作?
具身 Agent 关注的问题则是:
如何让整个系统根据现实反馈持续调用不同能力,最终完成目标?
这并不意味着模型不再重要,而是模型在系统中的位置发生了变化。
现有研究已经开始沿着这条路线推进。下面列举三个 2026 年的代表性工作:
- 2026 年 6 月,NVIDIA Research 发布 Vesta,把规划、工具调用和多模态记忆接入低层机器人模型。【1】
- 2026 年 7 月,以清华大学为主的团队发布 Harness VLA,将冻结的 VLA 作为可以重试的操作能力,由 Agent 结合记忆和其他工具持续调整。【2】
- 2026 年 9 月,以浙江大学为主的团队发布 EmbodiedSkills,在技能执行前检查条件,并在执行后验证结果。【3】
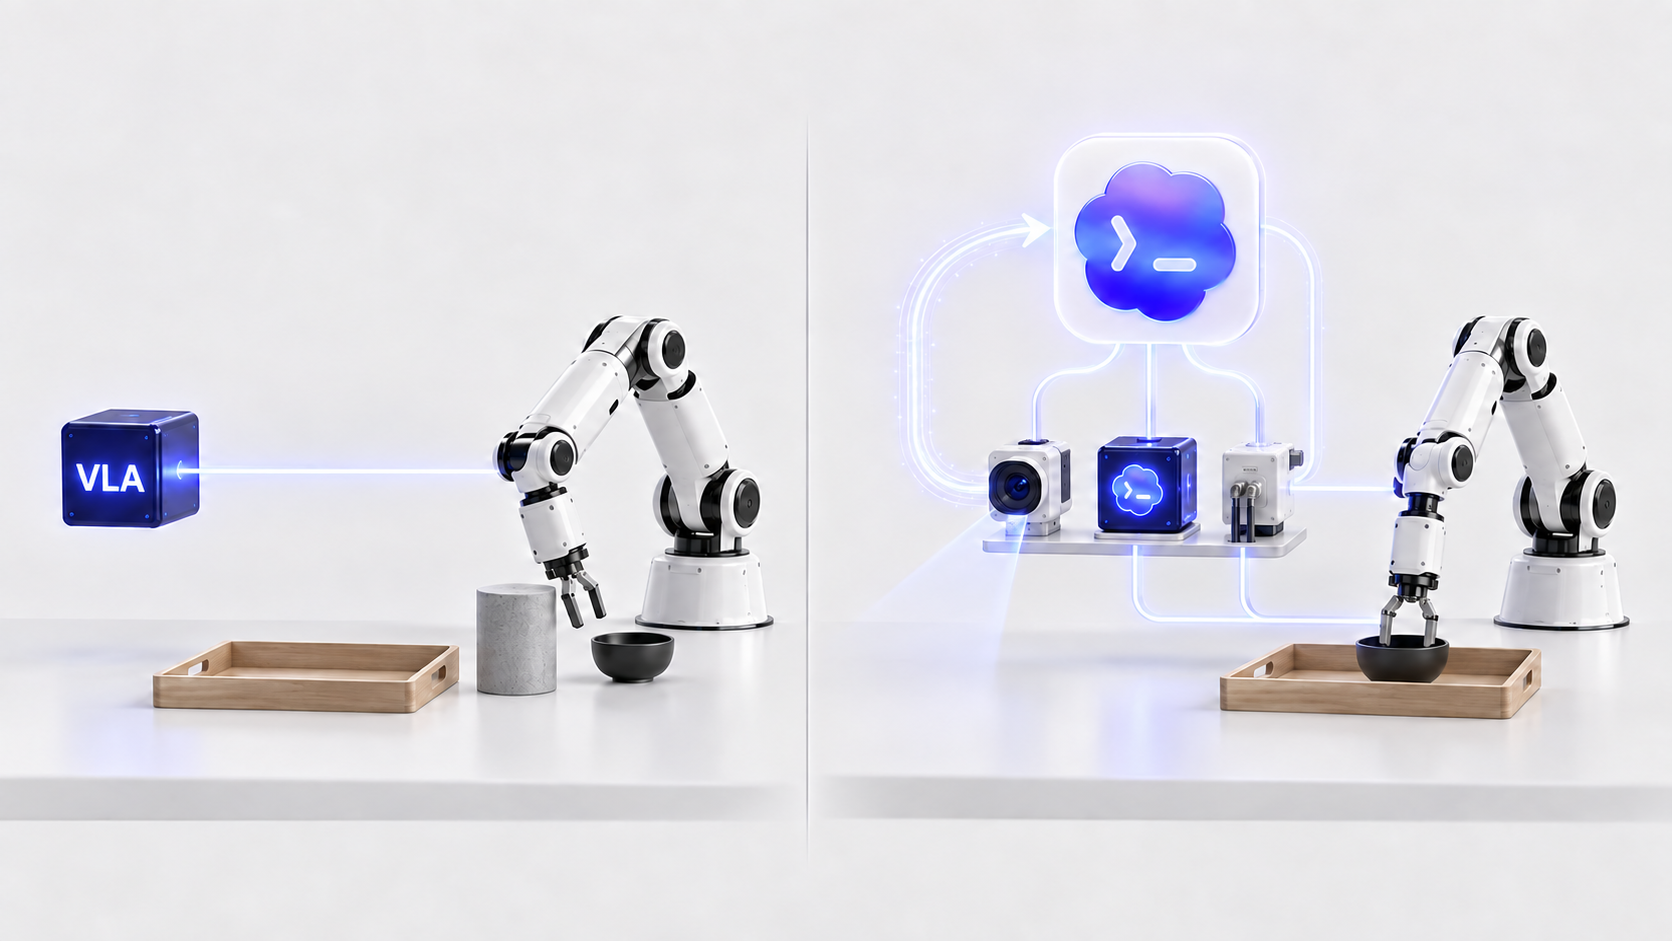
这些路线并不完全相同,但都指向同一个变化:具身智能正在从模型中心走向系统中心。
在前面讨论的 Planner+VLA 架构中,VLA 仍是中心,Planner 负责为它提供执行计划。而在具身 Agent 架构中,系统围绕现实目标组织规划、记忆和工具调用,VLA 是其中一种能力;系统根据执行结果决定继续、重试或调整。
区别不仅在于有没有反馈闭环,更在于从围绕模型安排计划,转向由系统组织能力、持续完成目标。
下一篇,我们继续讨论:为什么同一个 VLA 放进具身 Agent 系统以后,可以完成更多任务。
引用与来源
【1】Vesta: A Generalist Embodied Reasoning Model
NVIDIA Research
【2】Harness VLA: Steering Frozen VLAs into Reliable Manipulation Primitives via Memory-Guided Agents
arXiv:2607.08448
【3】EmbodiedSkills: A Unified Framework for Orchestrating, Training, and Deploying VLA Agents
arXiv:2609.01281
聊聊这篇文章