上一篇,我们讨论了系统如何通过任务编排、环境调整和记忆,让同一个 VLA 完成更多任务。
也就是说,VLA 可以是系统调用的一种能力。并且我认为,这一定是未来的趋势。既然如此,我们在设计和训练 VLA 时,就应该考虑它将如何被系统使用。
对此,我的思考分为三个方面:接口上,模型如何理解系统的要求;训练数据上,如何利用系统部署过程中产生的数据;以及最核心的,如何依托系统建立 VLA 的训练闭环,实现自进化。
一、接口:模型如何理解系统的要求
当 VLA、WAM 成为系统可以调用的策略模型,一个基本问题是:Agent 应该怎样告诉模型,自己希望它做什么?
例如,整理桌面时,Agent 已经理解了用户的要求,决定先把黑色杯子放到托盘上。
这一步决定,需要通过模型能够理解的方式传递下去。
最直接的方式是语言。
一种通用的划分方式是:做什么、对什么做,以及怎么做。
例如,“把黑色杯子放到托盘上,并保持杯口朝上”,就包含了操作任务、目标对象和执行方式这三个方面。
面向系统的模型,需要能够理解这些要求,并据此执行相应的操作。Agent 才能通过改变指令,组织同一个模型完成不同目标。
另一种方式是图像。
有些目标用画面更容易表达。例如,希望几件物品按照特定位置排列,Agent 可以提供参考画面或目标画面,让模型理解希望达到的状态。
这里要区分当前观察与目标图像:当前观察告诉模型“现在是什么样”,目标图像告诉模型“希望变成什么样”。
语言适合描述任务与要求,图像可以更直接地表达空间关系和目标状态。具体支持哪些表达方式,需要根据模型的能力设计,并在训练中建立对应关系。
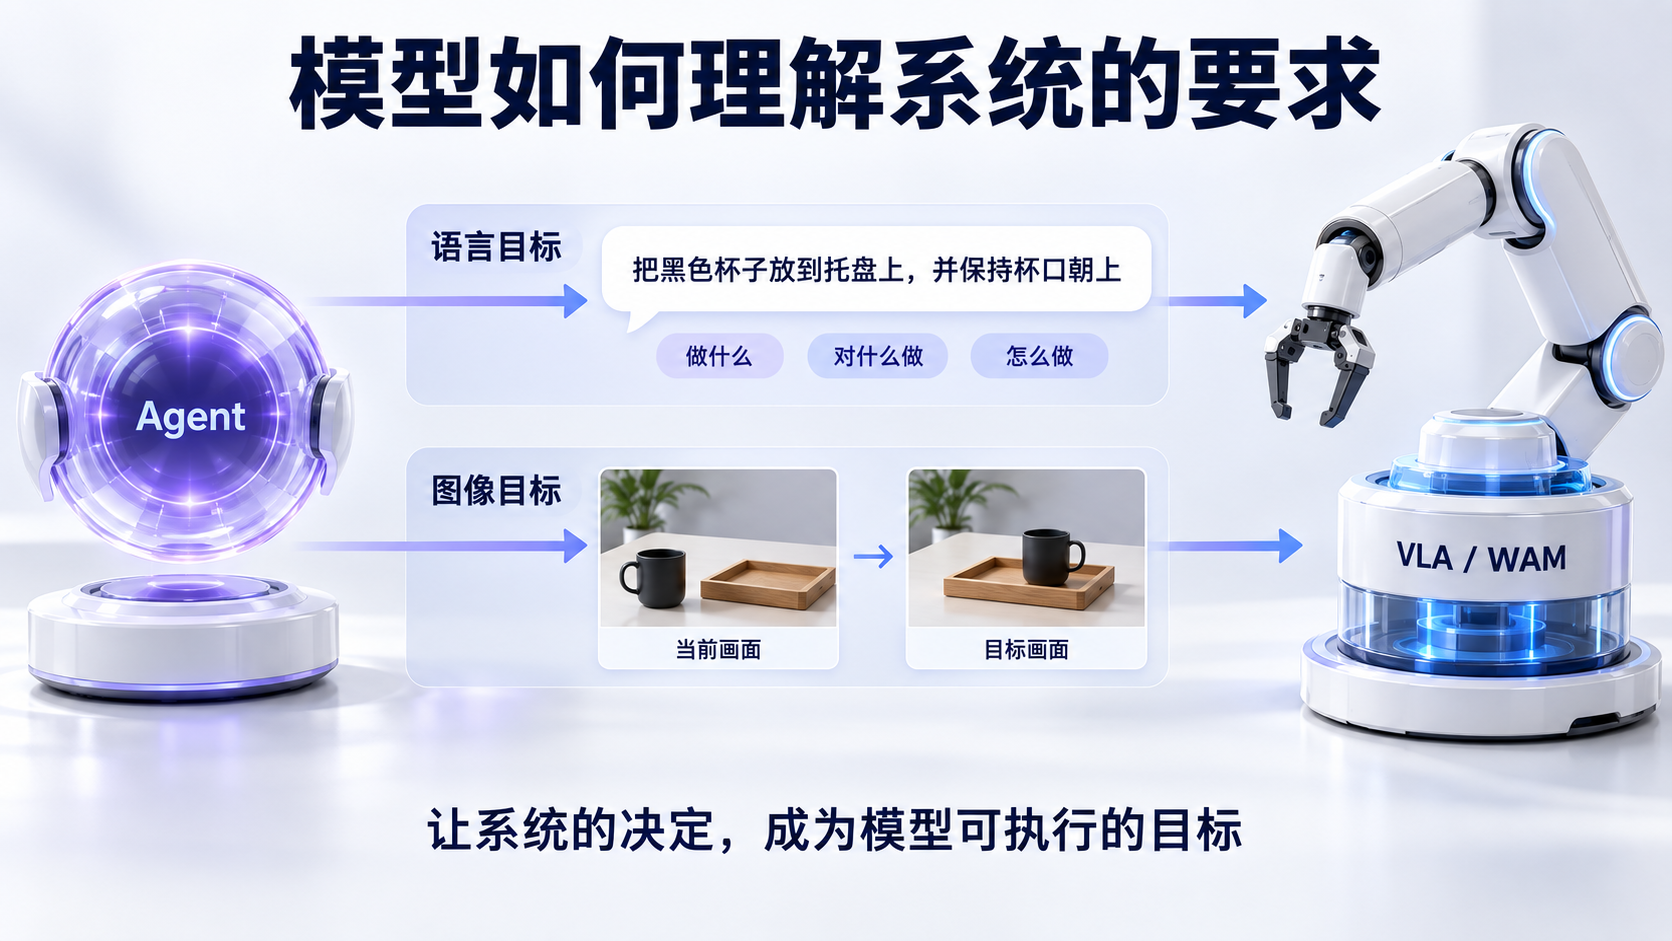
面向系统的接口,关键是让 Agent 的决定能够转化为模型可以执行的目标。
模型越能准确理解这些目标,系统就越能灵活地组织和复用它的能力。
二、训练数据:把系统增强的能力带回模型
过去,VLA 的训练数据主要依赖人工采集。当模型被放进具身 Agent 系统后,系统部署与运行的过程,也可以成为训练数据的来源。
当 Agent 理解场景、生成计划、调用模型和工具,并检查执行结果时,整个过程也在形成新的任务数据。
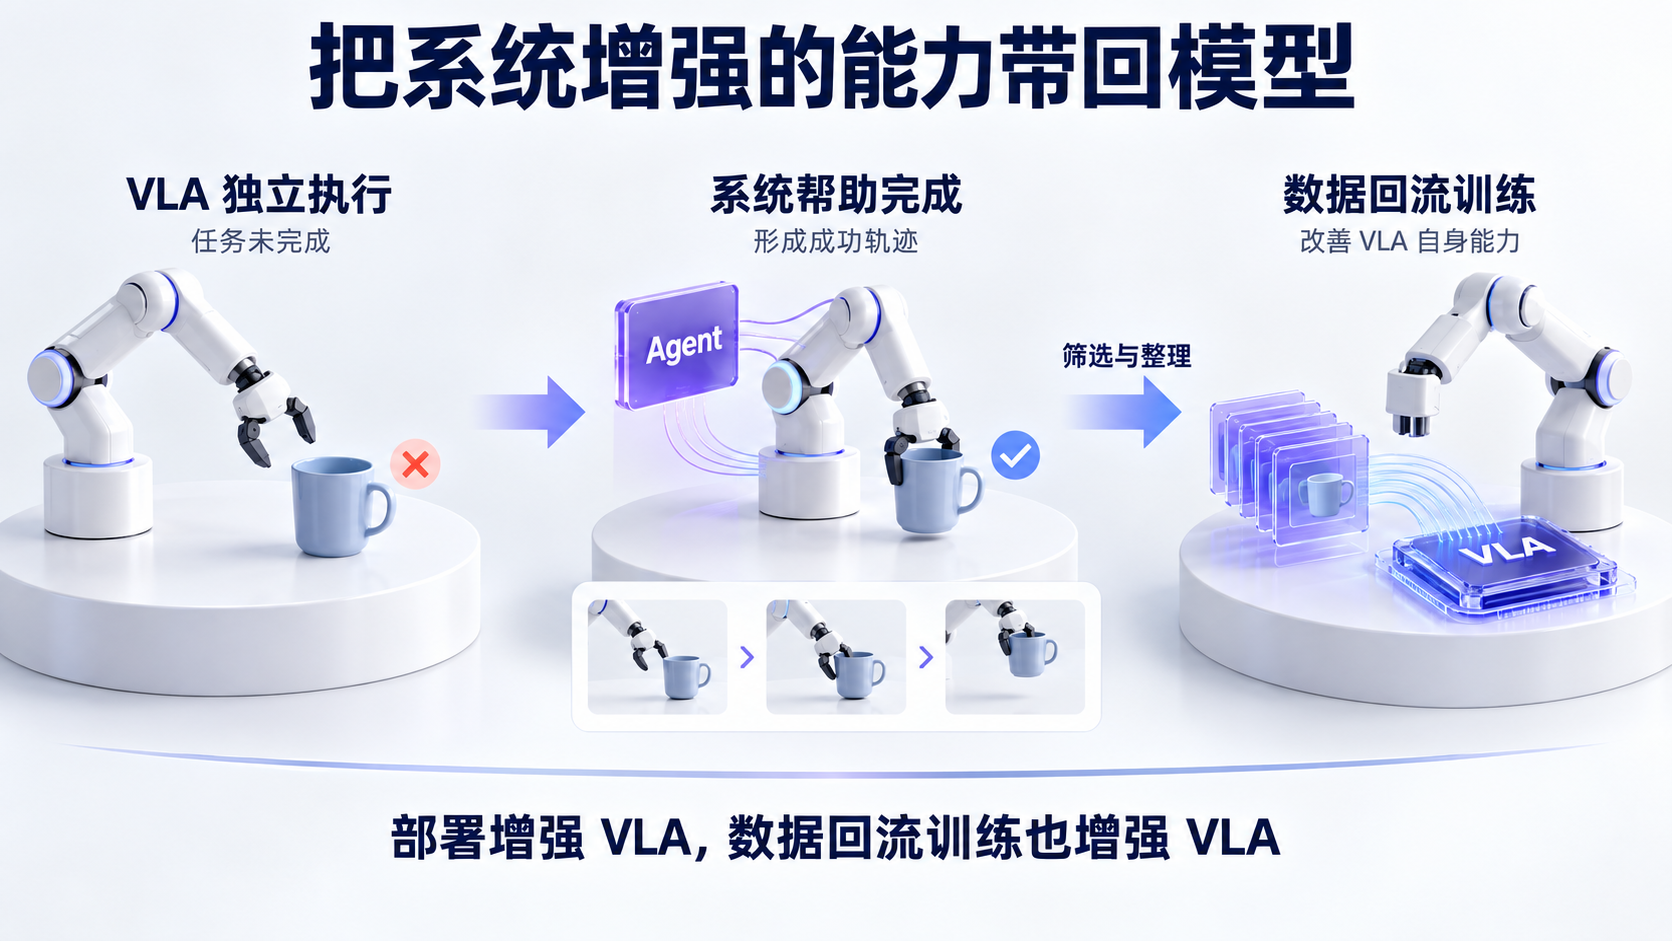
这些数据的价值在于:一些原本超出 VLA 独立能力范围的任务,借助系统能够完成,也就有了相应的成功轨迹。
例如,VLA 独立执行一项任务时容易失败,但 Agent 通过分解目标、调整执行条件、调用其他工具,最终完成了任务。这一过程就提供了模型独立执行时难以获得的数据。
经过筛选和整理,其中适合 VLA 学习的操作轨迹,可以用于回流训练,让模型学习原先需要系统帮助才能完成的操作。至于能吸收多少能力,取决于数据是否包含相应信息,以及模型能否学会;其他工具完成的动作,也需要与 VLA 的训练要求相匹配。
系统因此可以通过两条路径增强 VLA:部署时,用系统能力帮助它完成任务;训练时,把执行中获得的数据带回模型,改善它自身的能力。
不过,上述的数据训练和部署回流仍然是分离的。如果进一步把它们连接起来,那就进入了自进化闭环。
三、自进化闭环:围绕模型能力边界,持续组织下一轮学习
自进化的核心,是让系统根据模型当前的能力,持续组织下一轮学习。
Agent 通过记忆了解模型擅长什么、容易在哪里失败,再结合当前场景生成任务、组织执行,并评估任务结果与数据。这个过程可以分成前后相连的两段:
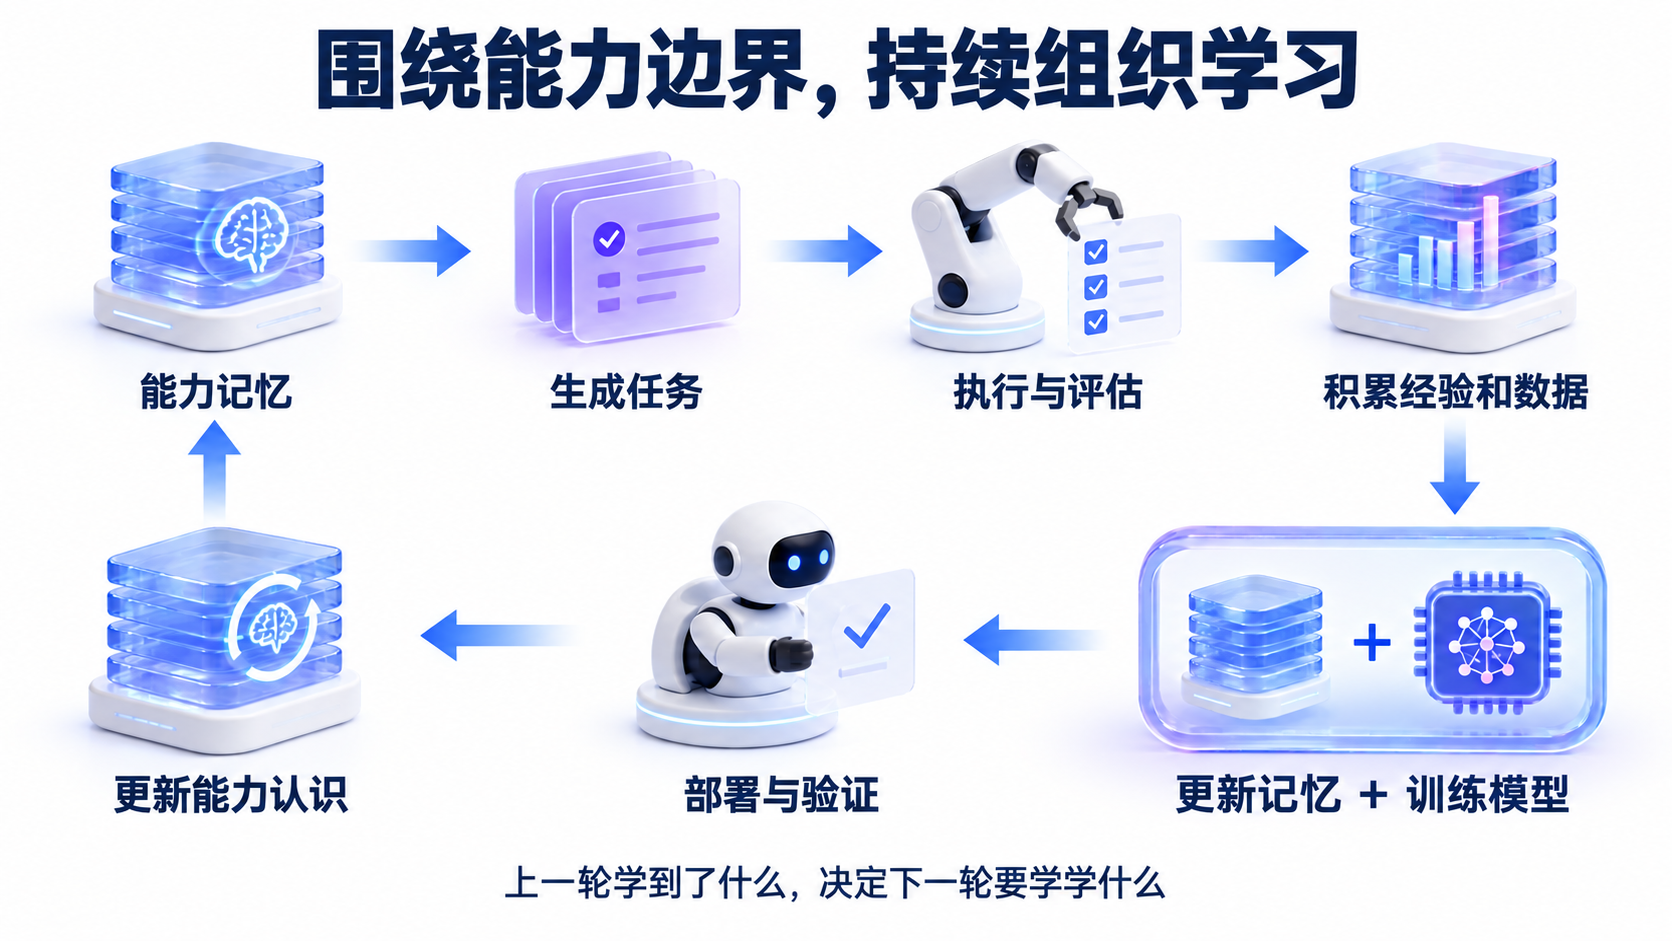
其中,更新记忆与训练模型,是经验转化为能力的两个方向。执行经验用于更新记忆,让 Agent 更了解怎样使用模型;经过筛选的数据用于训练,让模型本身获得能力改善。
新模型部署后,系统重新验证它的表现,修正对能力边界的认识,再据此组织下一轮任务。已经掌握的能力可以用于新的尝试,仍然存在的困难则继续指导数据积累与训练。
这样,任务执行、经验积累和模型更新就连接起来:上一轮学到了什么,决定下一轮继续学什么。
我认为,这是具身 Agent 最值得关注的方向之一。系统既在部署中增强 VLA,也通过数据回流训练增强 VLA,并围绕不断变化的能力边界,持续组织学习,实现自进化。
上述讨论还是建立在系统能力不变的情况下。实际上,以 Codex、Claude Code 为代表的智能系统,能力正在变得越来越强,它们的母公司也公开表达了向具身智能发展的方向。
这些变化会给我们今天构建的具身 Agent 系统带来怎样的影响?下一篇,我们来看看更远的未来。
聊聊这篇文章