上一篇文章里,我们分析了学生思维是如何被学校培养起来的。简单来说,学校本身提前定义了目标、提供了信息,把机会集中在少数几次考试中,并对失败给予惩罚。在这样的环境里,先找到正确答案,再开始行动,确实是一种有效的生存方式。
但进入真实世界以后,整个结构都发生了变化。
一、真实世界有着怎样的结构?
我们仍然沿用上一篇文章的结构:
定义目标 → 搜寻信息 → 发起行动 → 获取反馈
只不过,真实世界在这四个环节中,几乎都与学校相反。
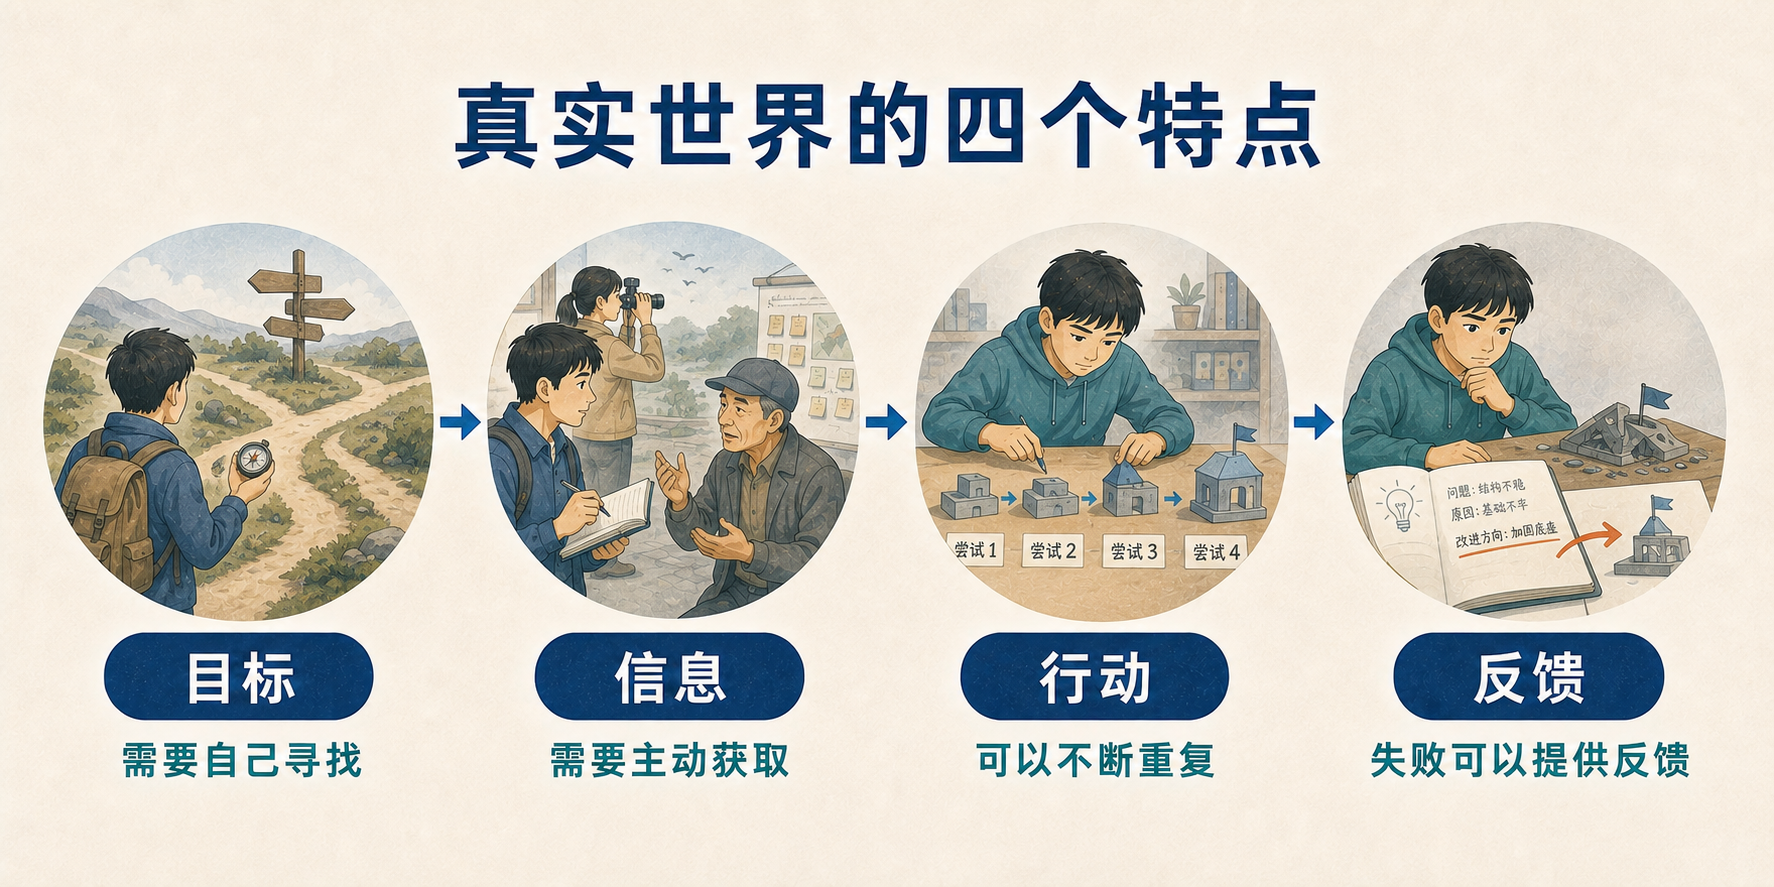
1. 目标需要自己寻找
在学校里,目标通常是明确的:考试取得高分、完成老师布置的任务、达到某项评价标准。
但在真实世界里,往往没有人告诉你什么才是值得追求的目标。
你需要自己判断想做什么、适合做什么。更麻烦的是,很多目标只有真正开始行动以后,才能知道自己是不是真的想要。
因此,真实世界里的目标不是一次定义完成的,它也需要不断调整。
2. 信息需要主动获取
学校会提前提供教材、课程和题目,学生只需要利用已有信息寻找答案。
但真实世界里的信息永远是不完整的。很多重要信息不在书本里,也无法仅靠搜索获得。
你只有真正进入一个环境,与具体的人交流,开始处理真实的问题,才能获得此前不知道的信息。
这意味着,行动不仅是为了完成目标,行动本身也是获取信息的方式。
3. 行动通常可以不断重复
学校里的重要机会往往是有限的。一场考试结束以后,通常很难重新来过。
但真实世界中的许多事情,并不是只有一次机会。一个方案不合适,可以修改;一个方向不适合,可以调整;第一次没有做好,也可以根据结果再试一次。
我们不一定要把一次行动变成决定命运的豪赌,而是可以把一个大问题拆成许多次小行动。
4. 失败可以提供反馈
学校里的失败通常意味着扣分、排名下降,以及来自老师和家长的批评。因此,学生会本能地认为失败是一件负面的事情。
但在真实世界里,失败往往意味着:我们对目标、环境或者行动方式的某些判断出了问题。
失败暴露了问题,也带来了原本没有的信息。只要一次失败的成本可以承受,它就能帮助我们调整下一次行动。
二、什么是迭代思维?
当目标尚未确定、信息并不完整的时候,我们不可能提前找到一个完美答案。
这时,更有效的方式是:
根据当前认知确定一个暂时的方向,先采取一次行动;通过行动获得新的信息和反馈,再调整自己的目标、认知与下一步行动。
整个过程可以概括为:
当前认知 → 发起行动 → 获取反馈 → 更新认知 → 再次行动
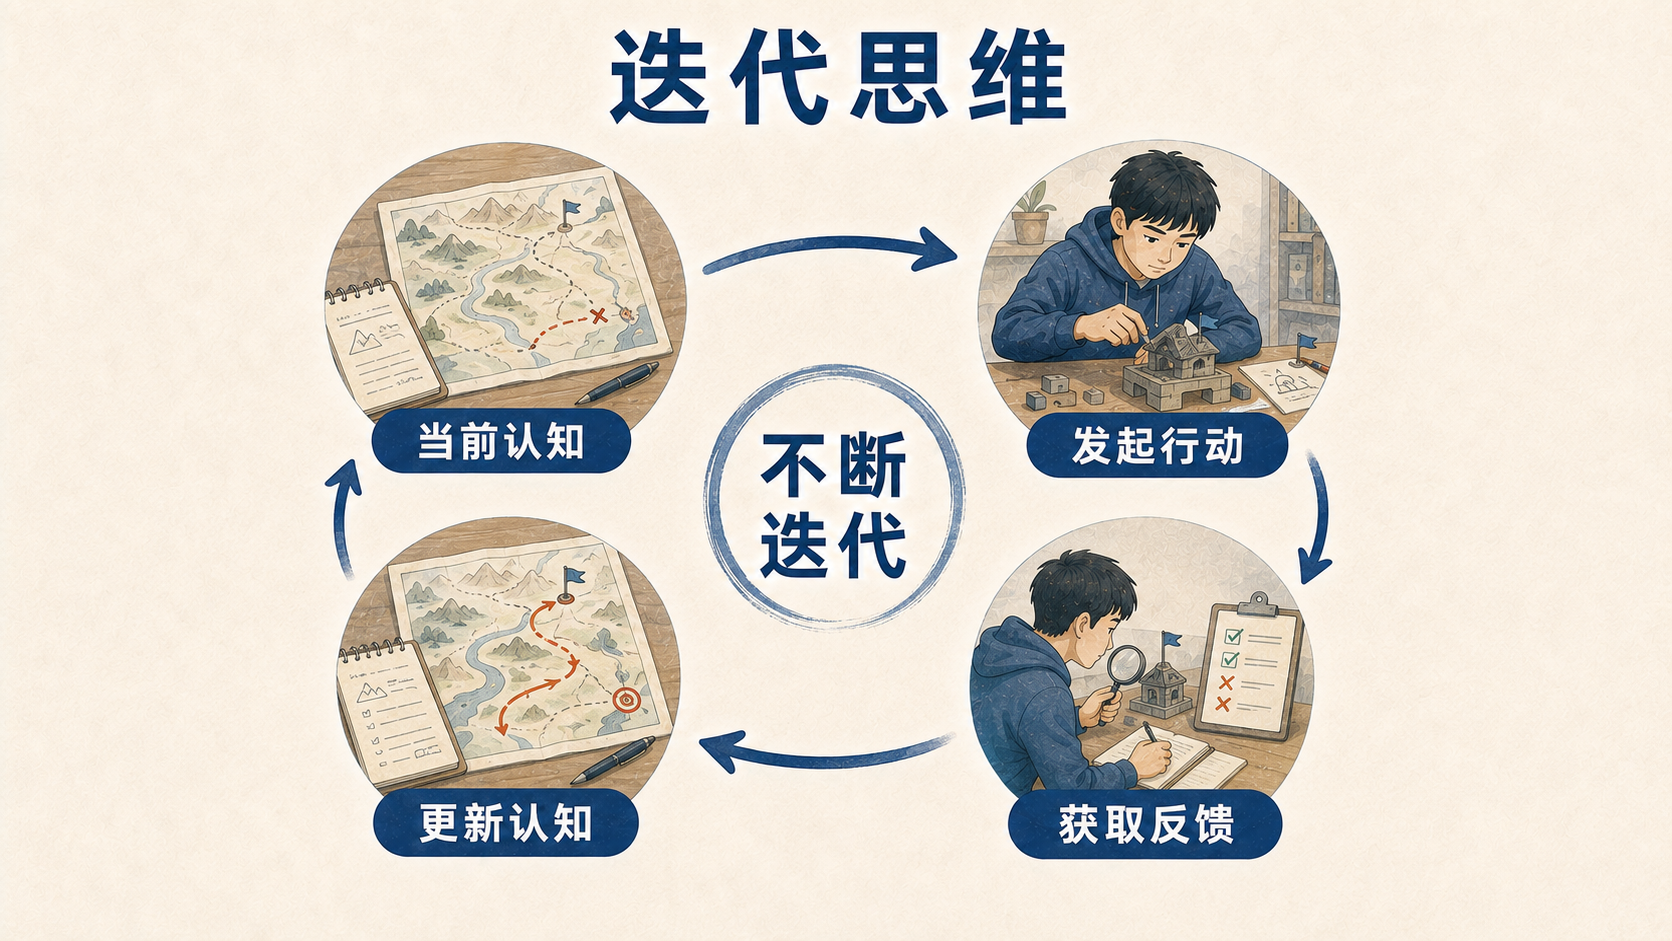
这就是迭代思维。
迭代不是不思考,也不是漫无目的地反复尝试。它是在当前认知下采取行动,再根据反馈调整方法;必要时,也重新审视自己的目标。
三、迭代思维为什么适合真实世界?
迭代思维之所以适合真实世界,是因为它恰好对应了真实世界的结构。
因为目标不确定,所以我们需要在行动中不断校准目标。
因为信息不完整,所以我们需要通过行动获取新的信息。
因为行动可以重复,所以我们不必要求自己第一次就做对,而可以通过多次迭代最终达到目标。
因为失败同样能够产生反馈,这些反馈跟成功一样重要,能帮助更新我们的认知。
许多人希望先掌握足够多的信息,找到最好的方案,再开始行动。
但问题在于:如果一些重要信息只有行动之后才会出现,那么站在原地继续思考,无论思考多久,都无法得到这些信息。
在这种情况下,行动并不是思考结束后的执行环节,而是认识世界的一部分。
真正有效的方案,往往不是在行动之前被完整设计出来的,而是在一次次行动和反馈中逐渐形成的。
四、迭代有效的两个跨领域例证
有价值的东西总是普世的。迭代并不只在人类行动中有效,在物种进化和神经网络训练这两个完全不同的领域中,我们也能看到相似的结构。
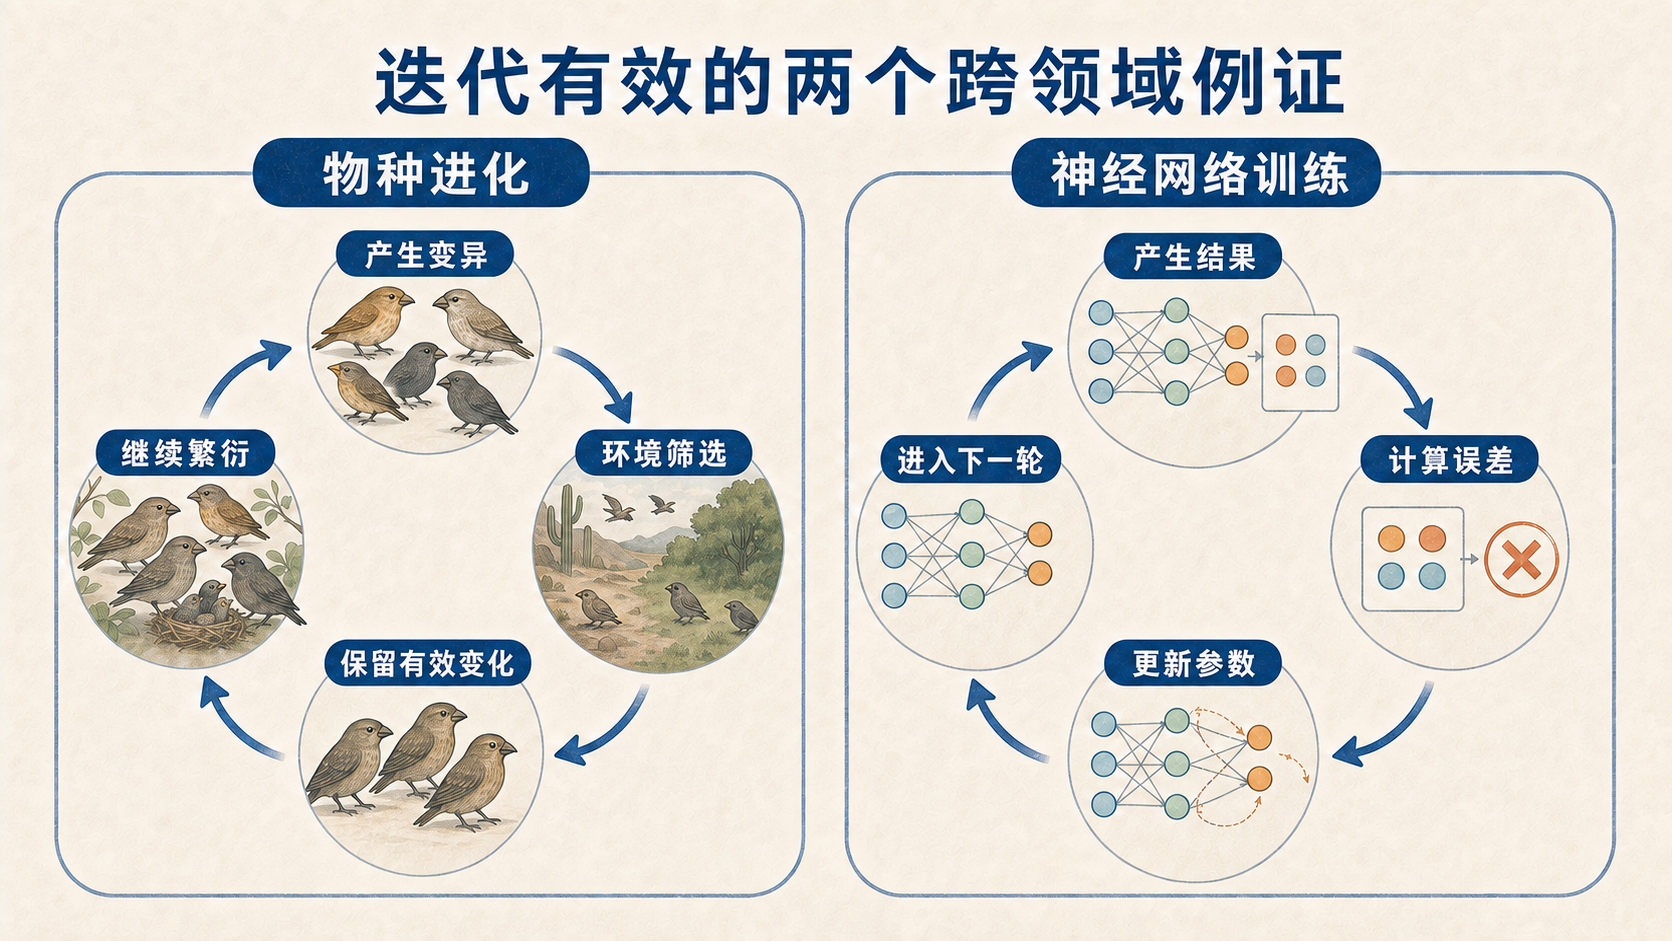
1. 物种进化
物种进化没有一个提前设计好的最终目标。
生物在繁衍过程中产生变异,环境对不同的变异进行筛选,更适应环境的特征更容易被保留下来,并进入下一轮繁衍。
整个过程可以概括为:
产生变化 → 接受环境反馈 → 保留有效变化 → 继续产生变化
进化并不知道未来的环境会是什么,也不会提前设计出一个完美物种。它只是通过无数次变化和筛选,让生命不断适应当下的环境。
如此复杂的生命,并不是被一次性设计出来的,而是在漫长的迭代中逐渐形成的。
2. 神经网络训练
神经网络的训练过程同样如此。
训练开始时,模型并不知道正确的参数应该是什么。它先使用当前参数产生结果,再计算结果与目标之间的误差,然后根据误差调整参数,进入下一轮训练。
整个过程可以概括为:
产生结果 → 计算误差 → 更新参数 → 再次产生结果
神经网络不是先找到一组完美参数,再开始完成任务。恰恰相反,它是在一次次产生误差和修正参数的过程中,逐渐获得能力的。
物种进化和神经网络训练,看起来是两个完全不同的过程,但它们都不是先找到答案再开始,而是在不断迭代中逐渐得到结果。
尾言
回到最开始那位学弟的问题:课程、比赛、实验室和实习,到底应该按照什么顺序安排?
也许这个问题本身就没有一个能够提前找到的标准答案。
真正有效的方式,是先进入一个能够获得反馈的环境,开始做一些具体的事情,再根据自己的兴趣、能力和实际结果不断调整。
因为在真实世界里,很多答案并不是被找到的。
它们是被一次次迭代出来的。
聊聊这篇文章